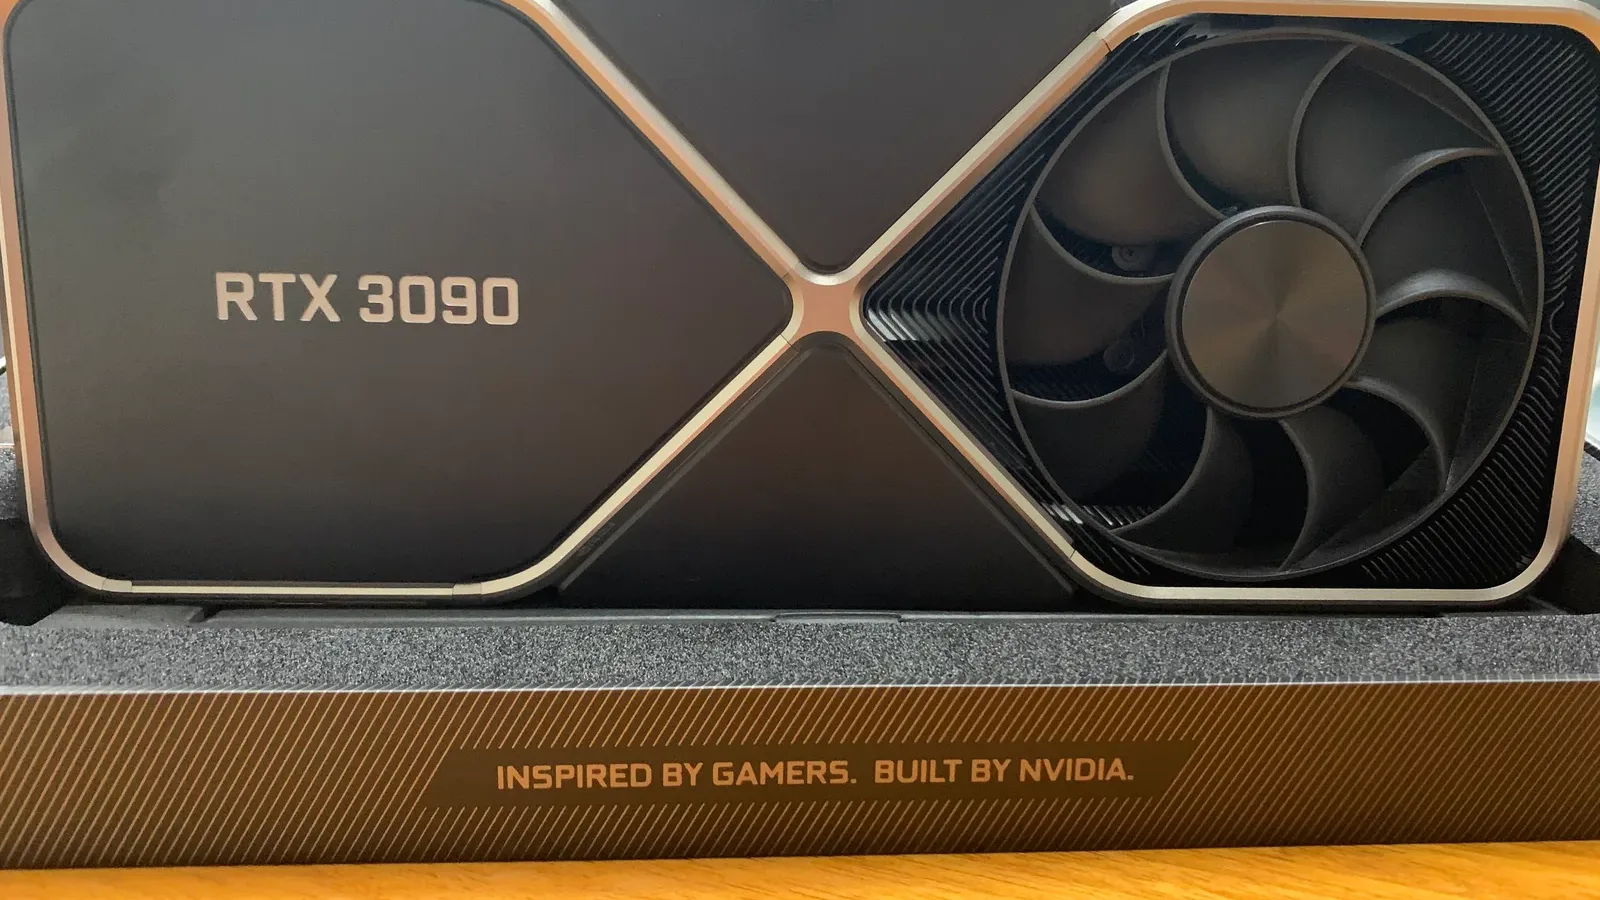
GeForce RTX 30 시리즈의 텐서코어 연산 제한을 풀어 준다는 오픈소스 도구가 화제다. 'gpu-unlock'이라는 이 도구는 GitHub 사용자 Zagitta가 만들었다. 커뮤니티 보고에서 RTX 3090의 BF16 행렬곱 성능이 77.5에서 129.6 TFLOPS로 약 67% 올랐다. 일부 매체 제목에는 '거의 두 배'라는 표현이 붙었다. 하지만 Notebookcheck은 이 표현이 보고된 수치보다 과장이라고 짚었다. 최고치도 대체로 67~80% 수준이다. 수치는 모두 사용자 보고이고 독립 검증은 없다. 게임 프레임 향상도 확인되지 않았다.
'무료 언락'의 정체 — 펌웨어 개조가 아닌 리눅스 커널 모듈
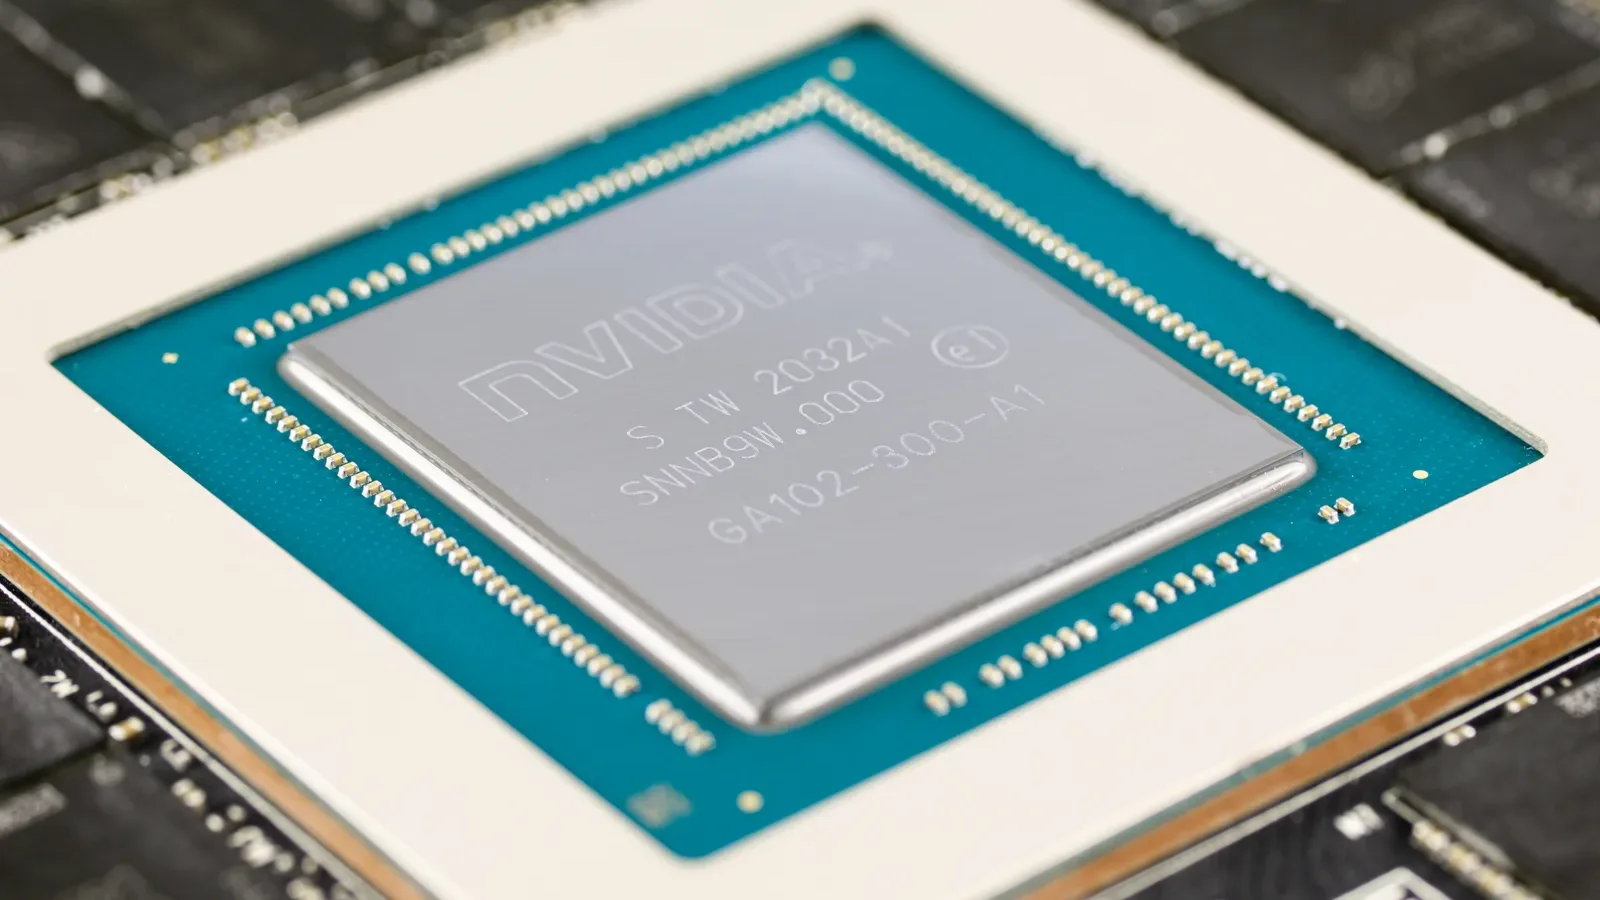
gpu-unlock은 리눅스 커널 모듈이다. 엔비디아 그래픽 드라이버가 카드를 붙잡기 전에 먼저 실행된다.
프로젝트 설명에 따르면 하드웨어의 속도 선택 레지스터 값을 바꾸고 GPU를 리셋한 뒤, 수정하지 않은 기존 드라이버에 제어를 넘긴다.
개발자는 이 방식이 하드웨어 개조나 패치된 엔비디아 드라이버를 요구하지 않는다고 밝혔다. VBIOS를 플래싱하거나 수정 펌웨어를 올리는 방식도 아니라고 한다.
겨냥하는 제한은 FP32로 누적하는 FP16·BF16 텐서코어 연산이다. 개발자는 GeForce에서 이 연산이 프로용 엔비디아 GPU의 대략 절반 속도로 묶여 있다고 설명한다.
프로젝트는 과거 엔비디아 CMP 마이닝 카드의 제한을 푸는 데 쓰인 연구를 토대로 한다.
대상 칩은 Ampere 세대의 GA102·GA103·GA104·GA106이다. 사용자가 대상 카드를 따로 지정해야만 작동하는 옵트인 방식이라고 README에 적혀 있다.
이 글은 적용 방법을 다루지 않는다. 아래에서는 보고된 수치와 한계만 정리한다.
보고된 수치 — RTX 3090 BF16 +67%, 3090 Ti +80%
Notebookcheck(10월 24일)이 인용한 커뮤니티 보고 수치는 아래와 같다. 행렬곱(GEMM) 기준 TFLOPS다.
RTX 3090은 BF16이 77.5에서 129.6으로 약 67%, TF32가 40.2에서 69.8로 약 74% 올랐다.
RTX 3090 Ti는 BF16이 87.5에서 157.4로 약 80% 올랐다. 'up to 80%'라는 요약이 여기서 나온다.
프로젝트 README에도 개발자가 직접 잰 3090 Ti 수치가 있다. 450W, 8192³ 밀집 GEMM, FP32 누적, 5회 측정 중앙값 기준이다.
이 값에서 FP16은 87.46에서 118.39 TFLOPS로 약 35%, BF16은 87.50에서 157.41로 약 80%, TF32는 42.58에서 82.61로 약 94% 올랐다.
TF32가 거의 두 배에 가까운 것은 맞다. 그러나 단일 카드·단일 워크로드 측정이고, FP16과 BF16은 그보다 상승폭이 작다.
즉 '거의 두 배'는 특정 연산에서만 근접하는 수치다. Notebookcheck도 헤드라인이 보고된 최고치 67~80%보다 과장됐다고 평가했다.
| 카드 / 연산 | 적용 전 | 적용 후 | 증가율 | 출처 |
|---|---|---|---|---|
| RTX 3090 / BF16 | 77.5 | 129.6 | 약 +67% | 커뮤니티 보고 |
| RTX 3090 / TF32 | 40.2 | 69.8 | 약 +74% | 커뮤니티 보고 |
| RTX 3090 Ti / BF16 | 87.5 | 157.4 | 약 +80% | 커뮤니티 보고 |
| RTX 3090 Ti / FP16 | 87.46 | 118.39 | 약 +35% | 개발자 README |
| RTX 3090 Ti / BF16 | 87.50 | 157.41 | 약 +80% | 개발자 README |
| RTX 3090 Ti / TF32 | 42.58 | 82.61 | 약 +94% | 개발자 README |
▲ 행렬곱 성능(TFLOPS). 모두 사용자·개발자 보고이며 독립 검증은 없다. 증가율은 근사치
워크로드별 편차 — LLM 프롬프트 처리는 +16%, 토큰 생성은 그대로
텐서코어 수학 성능이 오른다고 모든 작업이 빨라지지는 않는다.
RTX 3090에서 로컬 LLM을 돌린 한 보고에서는 긴 컨텍스트의 프롬프트 처리(prefill)가 약 16% 빨라졌다. 반면 토큰 생성 속도는 사실상 변하지 않았다.
RTX 3090 Ti의 ComfyUI 이미지 생성은 BF16 비중이 큰 여러 작업에서 처리량이 약 47~59% 높아졌다는 보고가 있다.
프로젝트 이슈 페이지에도 사용자 보고가 올라와 있다. 제목 기준으로 RTX 3090에서 BF16·FP16·TF32 +53~58%, vLLM prefill +33%, 토큰 생성 변화 없음 같은 내용이 보인다.
동작하지 않았다는 보고도 있다. RTX 3060 LHR과 썬더볼트로 연결한 RTX 3090에서는 실패 보고가 있고, 일부 3080 Ti OEM 카드는 BF16 속도가 그대로였다고 한다.
이 보고들은 개별 사용자가 올린 것이다. 같은 조건에서 비교한 독립 벤치마크는 확인되지 않았다.
게임은 어떨까 — 검증된 프레임 향상 없음
게임 성능은 이번 보고의 핵심이 아니다. 검증된 게임 벤치마크에서 FPS 향상이 확인된 사례는 아직 없다.
DLSS가 텐서코어를 쓰기 때문에 이론상 영향이 있을 수는 있다. Notebookcheck도 가능성만 언급했고 확인된 결과로 다루지 않았다.
그래서 게이머가 기대할 근거는 현재로서는 없다. 수혜가 보고된 영역은 AI 추론·이미지 생성 같은 텐서코어 의존 작업이다.
한계와 위험 — 리눅스 전용 실험 단계
원래 프로젝트는 리눅스 전용이다. 별도의 윈도 포팅이 특정 시스템에서 부팅됐다는 보고가 있으나 실험 단계다.
프로젝트 README가 밝힌 주의점은 다음과 같다. GPU가 모니터를 구동 중이면 리셋 동안 화면이 꺼지고, 엔비디아 드라이버가 인계받을 때까지 이어진다.
절전(S3) 복귀 때는 속도 설정이 초기화돼 모듈이 다시 실행된다. 이때 약 1초가 더 걸린다. 최대 절전은 다루지 않는다.
카드 펌웨어가 멈추지 않으면 일부 DMA 버퍼가 다음 완전 전원 차단 때까지 메모리에 남을 수 있다.
부팅 초기 단계에서 GPU 레지스터를 건드리고 부팅 설정에 관여하므로, 잘못 다루면 부팅에 영향을 줄 수 있다고 README는 경고한다.
Notebookcheck도 주력 게임 PC에 적용하면 위험이 따른다고 썼지만, 구체적인 위험 내용은 적지 않았다.
엔비디아의 공식 입장은 확인하지 못했다. 보증이나 하드웨어 손상과 관련한 언급도 참고한 자료에서는 찾지 못했다.
정리 — 'RTX 3090 부활'이라 부르기엔 아직 이르다
확인된 사실은 이렇다. 텐서코어 BF16·TF32 행렬곱에서 RTX 3090은 약 67~74%, 3090 Ti는 BF16 기준 약 80% 올랐다는 보고가 있다.
확인되지 않은 것도 분명하다. 독립 검증, 게임 효과, 엔비디아의 입장, 보증 영향이 그렇다.
중고 3090을 로컬 AI용으로 쓰는 사용자에게는 관심 갈 소식이다. 다만 리눅스 전용 실험 소프트웨어라는 점을 전제로 보는 편이 맞다.
엔비디아 하드웨어 시장 상황은 RTX 5090 공급 관련 기사와 메모리 대란 정리에서 이어서 볼 수 있다.